基于大数据的科技成果转化服务数据处理方法及系统 数据处理服务的创新架构与实践
一、引言
科技成果转化是连接科研产出与产业应用的关键桥梁,其效率直接关系到国家创新驱动发展战略的实施效果。科技成果转化过程中涉及大量异构、多源、非结构化的数据——包括专利文献、技术需求、专家信息、企业画像、市场情报、政策法规等,传统的人工处理方式已难以满足高时效、高精度的服务需求。基于大数据的科技成果转化服务数据处理方法及系统,正是为解决这一痛点而提出的技术方案,其核心在于构建一套完整的数据处理服务体系,实现从数据采集、清洗、融合到分析、匹配、推荐的全链路智能化处理。
二、科技成果转化数据的特征与挑战
2.1 数据来源的多元性
科技成果转化服务涉及的数据源极为广泛:供给侧包括高校院所的科研成果、专利数据、技术秘密、科研团队信息;需求侧包括企业的技术需求、产业痛点、生产数据;此外还有政策数据、资本数据、人才数据、赛事数据等。这些数据分散在不同的机构和系统中,格式各异、标准不一,给数据整合带来极大困难。
2.2 数据结构的异构性
成果转化数据既有结构化数据(如专利著录项目、企业工商信息),也有半结构化数据(如XML格式的科技报告),还有大量非结构化数据(如技术文档、研究报告、专家论文、新闻资讯)。如何对这些异构数据进行统一表示和有效处理,是系统设计的关键挑战。
2.3 数据质量的参差性
实际获取的成果转化数据往往存在缺失值、重复记录、表述歧义、时效性差异等问题,直接影响后续分析匹配的准确性。因此,数据清洗与质量控制必须贯穿数据处理的全流程。
三、数据处理方法体系
3.1 多源异构数据采集与融合
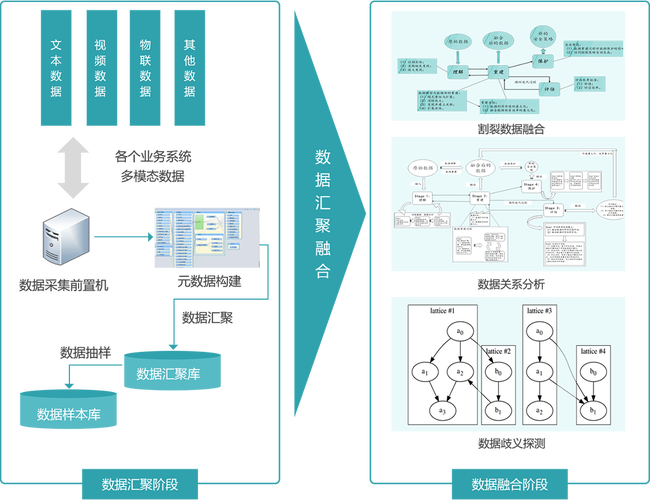
系统采用分布式爬虫框架与API接口对接相结合的方式,实现多源数据的自动化采集。针对不同数据源制定差异化的采集策略:对专利数据通过官方数据库接口批量获取;对企业需求数据通过NLP技术从公开信息中抽取;对专家信息通过学术数据库和机构网站整合。采集后的数据进入统一的数据湖进行初步归集,并建立数据血缘追踪机制。
在数据融合层面,采用基于本体的知识表示方法,构建科技成果转化领域本体(Ontology),将不同来源的数据映射到统一的概念框架下。例如,将专利中的IPC分类号、论文中的关键词、企业需求中的技术标签统一映射到领域技术知识图谱的节点上,实现语义层面的数据对齐。
3.2 数据清洗与质量提升
针对成果转化数据的质量问题,设计多层次清洗流水线:
- 去重与消歧:采用基于SimHash的近似去重算法处理重复记录,结合实体消歧技术解决同一机构/专家在不同数据源中的名称变体问题(如“清华大学”与“清华大學”、“Tsinghua University”的归一化)。
- 缺失值填补:对关键字段的缺失,利用知识图谱的关联推理进行补全,如通过专利发明人关联到专家信息库补全技术领域标签。
- 时效性管理:建立数据时效性标签体系,对不同类型数据设定不同的有效期策略,确保转化匹配时使用最新数据。
3.3 数据标注与知识抽取
运用自然语言处理技术对非结构化文本进行深度加工:
- 命名实体识别(NER):从技术文档、需求描述中识别技术术语、材料名称、工艺方法等实体。
- 关系抽取:提取“技术—应用领域”“成果—完成人”“需求—技术指标”等关系,构建领域知识图谱。
- 文本分类与聚类:对成果和需求进行技术领域自动分类,采用层次化分类体系(参考《国民经济行业分类》与《国家重点支持的高新技术领域》),支持多标签分类。
3.4 智能匹配与推荐算法
数据处理的最终目标是为成果供需双方提供精准匹配。系统采用多策略融合的匹配方法:
- 基于内容相似度的匹配:利用文本向量化技术(如BERT等预训练模型)计算成果描述与需求描述之间的语义相似度。
- 基于知识图谱的关联匹配:通过技术知识图谱中节点间的路径关系,发现潜在的间接匹配机会(如某材料的成果可应用于多个看似不相关的行业)。
- 协同过滤与行为分析:基于历史转化成功案例和用户行为数据,构建协同过滤模型,提升推荐的个性化程度。
- 多目标优化排序:综合考虑匹配度、转化可行性、市场前景、成熟度等多维指标,采用加权排序模型输出推荐结果。
3.5 数据安全与隐私保护
成果转化数据中涉及大量商业秘密和技术秘密,系统在数据处理全流程中嵌入安全机制:数据分级分类管理、敏感字段脱敏处理、访问权限的细粒度控制、数据使用的审计追踪,以及基于联邦学习的跨机构数据协同处理方案,在不暴露原始数据的前提下实现联合建模。
四、系统架构设计
4.1 总体架构
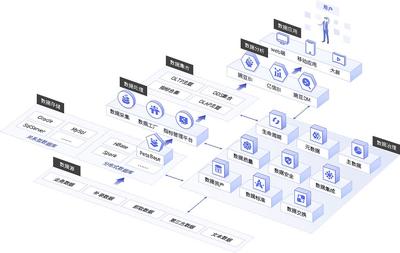
系统采用分层架构设计,自下而上包括:
- 数据源层:对接专利数据库、科技管理信息系统、企业信息平台、学术数据库等多源数据。
- 数据采集与存储层:包括分布式采集组件、数据湖(存储原始数据)、数据仓库(存储清洗后的结构化数据)、图数据库(存储知识图谱)、向量数据库(存储文本嵌入向量)。
- 数据处理层:涵盖数据清洗、标注、抽取、融合等处理流水线,以微服务方式部署,支持弹性扩展。
- 分析服务层:提供匹配推荐、趋势分析、技术预见、竞争情报等分析服务API。
- 应用层:面向成果转化服务机构、高校技术转移中心、企业等用户,提供成果发布、需求对接、智能推荐、转化跟踪等功能模块。
4.2 关键技术组件
- 数据处理流水线引擎:基于工作流编排技术,将数据清洗、转换、加载等步骤编排为可配置的流水线,支持批处理与流处理混合模式。
- 知识图谱存储与推理引擎:采用图数据库存储技术知识图谱,支持SPARQL查询和基于规则的推理。
- 向量检索引擎:基于FAISS或Milvus等向量数据库,实现大规模文本向量的高效相似度检索。
- 模型服务框架:统一管理NER、文本分类、语义匹配等NLP模型的训练、部署与版本迭代。
4.3 数据流转机制
系统内数据以“采集—入湖—清洗—加工—服务”为主线流转。原始数据入湖后打上来源、时间、质量等元数据标签;清洗加工后的数据进入主题数据库,按成果库、需求库、专家库、企业库等主题组织;知识图谱和向量索引作为派生数据产品持续更新;最终通过API网关对外提供数据服务,并记录服务调用日志用于效果评估和模型迭代。
五、数据处理服务的应用场景
5.1 成果智能推荐
当企业发布技术需求后,系统自动对需求文本进行解析和向量化,在成果库中检索语义相似的科技成果,并结合知识图谱关联分析,输出按匹配度排序的成果推荐列表,同时给出匹配理由(如技术领域契合、已有类似转化案例等)。
5.2 技术需求挖掘
通过对企业公开信息、专利布局、产品描述等数据的持续监测与分析,主动识别企业潜在的技术需求,为技术转移机构提供需求挖掘服务,变被动对接为主动服务。
5.3 转化路径分析与风险预警
基于历史转化数据和技术演进趋势,分析特定成果的转化路径可行性,识别转化过程中的潜在风险(如技术成熟度不足、市场需求不确定、知识产权纠纷风险等),为转化决策提供数据支撑。
5.4 区域创新能力监测
聚合区域内的成果、人才、企业、资本等数据,构建区域科技成果转化活力指数,为政府科技管理部门提供动态监测和决策参考。
六、实践挑战与发展趋势
6.1 当前面临的主要挑战
- 数据壁垒:成果转化数据分散在不同部门和机构,数据共享机制尚不健全,跨机构数据融合存在制度和技术双重障碍。
- 标注成本高:高质量的训练数据需要领域专家参与标注,成本高、周期长,制约了模型的迭代速度。
- 评价体系缺失:匹配推荐效果的评估缺乏公认的指标体系和基准数据集,难以横向比较不同方法的效果。
6.2 发展趋势
- 大语言模型的应用:利用大语言模型强大的语义理解和生成能力,提升成果描述解析、需求理解、匹配解释等方面的效果,降低对人工标注的依赖。
- 隐私计算与数据协同:联邦学习、安全多方计算等技术将在跨机构数据协同处理中发挥更大作用,在保护数据安全的前提下释放数据价值。
- 实时化与智能化:从批处理向流式处理演进,实现需求的实时响应和动态匹配;从规则驱动向数据驱动和知识驱动相结合演进,提升系统的自适应能力。
- 标准化建设:成果转化数据描述标准、接口标准、质量评价标准的建立,将为跨系统互联互通和产业生态构建奠定基础。
七、
基于大数据的科技成果转化服务数据处理方法及系统,是信息技术与科技服务业深度融合的产物。其核心价值在于通过系统化的数据处理方法,将分散、异构、低质量的数据转化为可计算、可关联、可推理的知识资产,并在此基础上提供精准、高效的转化服务。随着数据资源的持续积累、算法能力的不断提升和应用场景的深入拓展,这一技术体系将在加速科技成果向现实生产力转化的过程中发挥越来越重要的作用。
如若转载,请注明出处:http://www.xitengtech.com/product/32.html
更新时间:2026-10-24 03:12:35