基于Hologres的典型实时数据处理架构 数据处理服务
引言
在数字化转型的浪潮中,实时数据处理能力已成为企业竞争力的核心要素。Hologres作为阿里云自研的一站式实时数仓引擎,凭借其高并发、低延迟、混合负载等特性,为构建实时数据处理架构提供了强大的支撑。本文将深入探讨基于Hologres的典型实时数据处理架构,并重点剖析其中的数据处理服务层,揭示如何利用Hologres构建高效、稳定的实时数据流水线。
一、实时数据处理架构概览
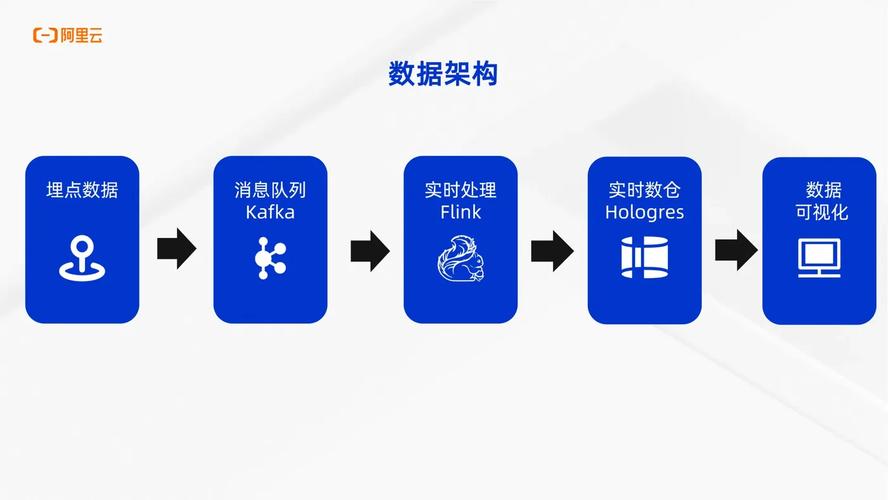
一个典型的基于Hologres的实时数据处理架构通常包含以下几个层次:
- 数据源层:包括业务数据库(如MySQL、Oracle)、日志文件、消息队列(如Kafka、RocketMQ)等,产生实时数据流。
- 数据采集层:通过CDC工具(如Flink CDC、Canal、Debezium)或日志采集工具(如Fluentd、Logstash)将数据实时抽取并推送到消息队列或直接写入Hologres。
- 数据处理服务层:作为架构的核心,负责数据的清洗、转换、聚合、关联等实时计算逻辑,并最终将结果写入Hologres。
- 数据存储与服务层:Hologres作为实时数仓,提供高性能的存储和查询服务,支持高并发点查、OLAP分析以及离线数据的联邦查询。
- 数据应用层:包括实时大屏、BI报表、Ad-hoc查询、API服务等,直接消费Hologres中的数据。
在这个架构中,数据处理服务层承上启下,是保证数据实时性和准确性的关键环节。
二、数据处理服务的关键组件
数据处理服务主要负责对接数据采集层,执行实时计算任务,并将结果写入Hologres。其核心组件包括:
- 计算引擎:通常采用Flink,因其具备 exactly-once 语义、事件时间处理、窗口计算等能力, perfect for streaming ETL。其他如Spark Streaming、Storm也可作为备选。
- 连接器:Flink提供了丰富的Connector,如Kafka Source、Hologres Sink等。Hologres Sink支持批量写入、幂等写入,确保数据不丢不重。
- 维表关联:在实时处理中,经常需要关联维度数据(如用户信息、商品详情)。Hologres可作为维表存储,Flink通过Async I/O或Lookup Join实现低延迟关联。
- 状态管理:Flink的状态后端(如RocksDB)用于维护聚合状态,保证容错。
- 监控与运维:通过Prometheus、Grafana等监控数据处理服务的延迟、吞吐、异常等指标,确保服务稳定。
三、典型的数据处理流程
以电商实时订单分析为例,数据处理服务的典型流程如下:
- 数据接入:订单数据库的Binlog通过Canal采集到Kafka,形成订单变更流。
- 数据清洗与转换:Flink消费Kafka中的订单流,过滤无效数据,解析JSON,提取关键字段,并进行标准化。
- 维表关联:通过订单中的用户ID和商品ID,异步查询Hologres中的用户维表和商品维表,补充用户等级、商品类目等信息。
- 聚合计算:按分钟级窗口统计各类目销售额、订单量等指标。
- 结果写入:将聚合结果和明细数据分别写入Hologres的不同表中。聚合结果表用于实时大屏,明细表用于即席查询。
- 数据服务:前端应用通过Hologres提供的PostgreSQL接口查询实时数据。
这一流程中,Hologres不仅作为结果存储,还作为维表存储,与Flink紧密配合。
四、Hologres在数据处理服务中的优势
为什么选择Hologres作为数据处理服务的目标存储和维表存储?
- 高吞吐写入:Hologres支持高并发的写入,单表写入可达百万TPS,满足Flink大批量写入需求。
- 低延迟查询:基于列式存储和向量化引擎,Hologres提供毫秒级查询响应,非常适合实时维表关联。
- 统一接口:兼容PostgreSQL协议,Flink可以直接使用JDBC连接,简化开发。
- 资源隔离:支持计算组隔离,避免实时写入和查询相互影响。
- 生态集成:与Flink、MaxCompute、DataWorks等无缝集成,方便构建端到端实时数仓。
五、最佳实践与优化建议
为了构建稳定高效的数据处理服务,建议遵循以下实践:
- 合理设计Hologres表:根据查询模式选择行存、列存或行列共存;设置合适的分布键和聚簇索引,提升查询性能。
- 批量写入优化:调整Flink Hologres Sink的批大小、间隔,利用Hologres的批量写入接口,提高吞吐。
- 维表关联优化:对于频繁关联的维表,可开启Hologres的本地缓存或使用Flink的Async I/O,并设置合理的缓存过期策略。
- 资源规划:根据数据量和并发量,合理规划Hologres实例规格和Flink集群资源。
- 数据一致性:利用Flink的Checkpoint和Hologres的幂等写入,保证端到端的Exactly-Once语义。
- 监控告警:对数据处理服务的延迟、失败率、Hologres的写入响应时间等指标进行监控,及时发现瓶颈。
六、
基于Hologres的实时数据处理架构中,数据处理服务是连接数据源与数据应用的桥梁。通过Flink等计算引擎与Hologres的深度集成,企业可以构建高吞吐、低延迟、Exactly-Once的实时数据流水线,支撑实时大屏、实时风控、实时推荐等多种场景。随着Hologres的持续演进,其实时数据处理能力将更加强大,为企业的实时化转型提供坚实底座。
如若转载,请注明出处:http://www.xitengtech.com/product/11.html
更新时间:2026-10-24 10:53:11